识别会把我的音频或视频传走吗?
不会。识别和改字幕都在你的电脑上完成,声幕没有云端识别。应用只读取你选中的文件,并在本机保存字幕、草稿和必要的临时文件。
 声幕 SpeechSub
English
macOS 桌面应用 · 本机语音识别与字幕校对
声幕在你的 Mac 上把语音转成字幕,再让你对着波形改到能用。
识别在这台电脑上完成。你选择的音频和视频不会上传到声幕的服务器。
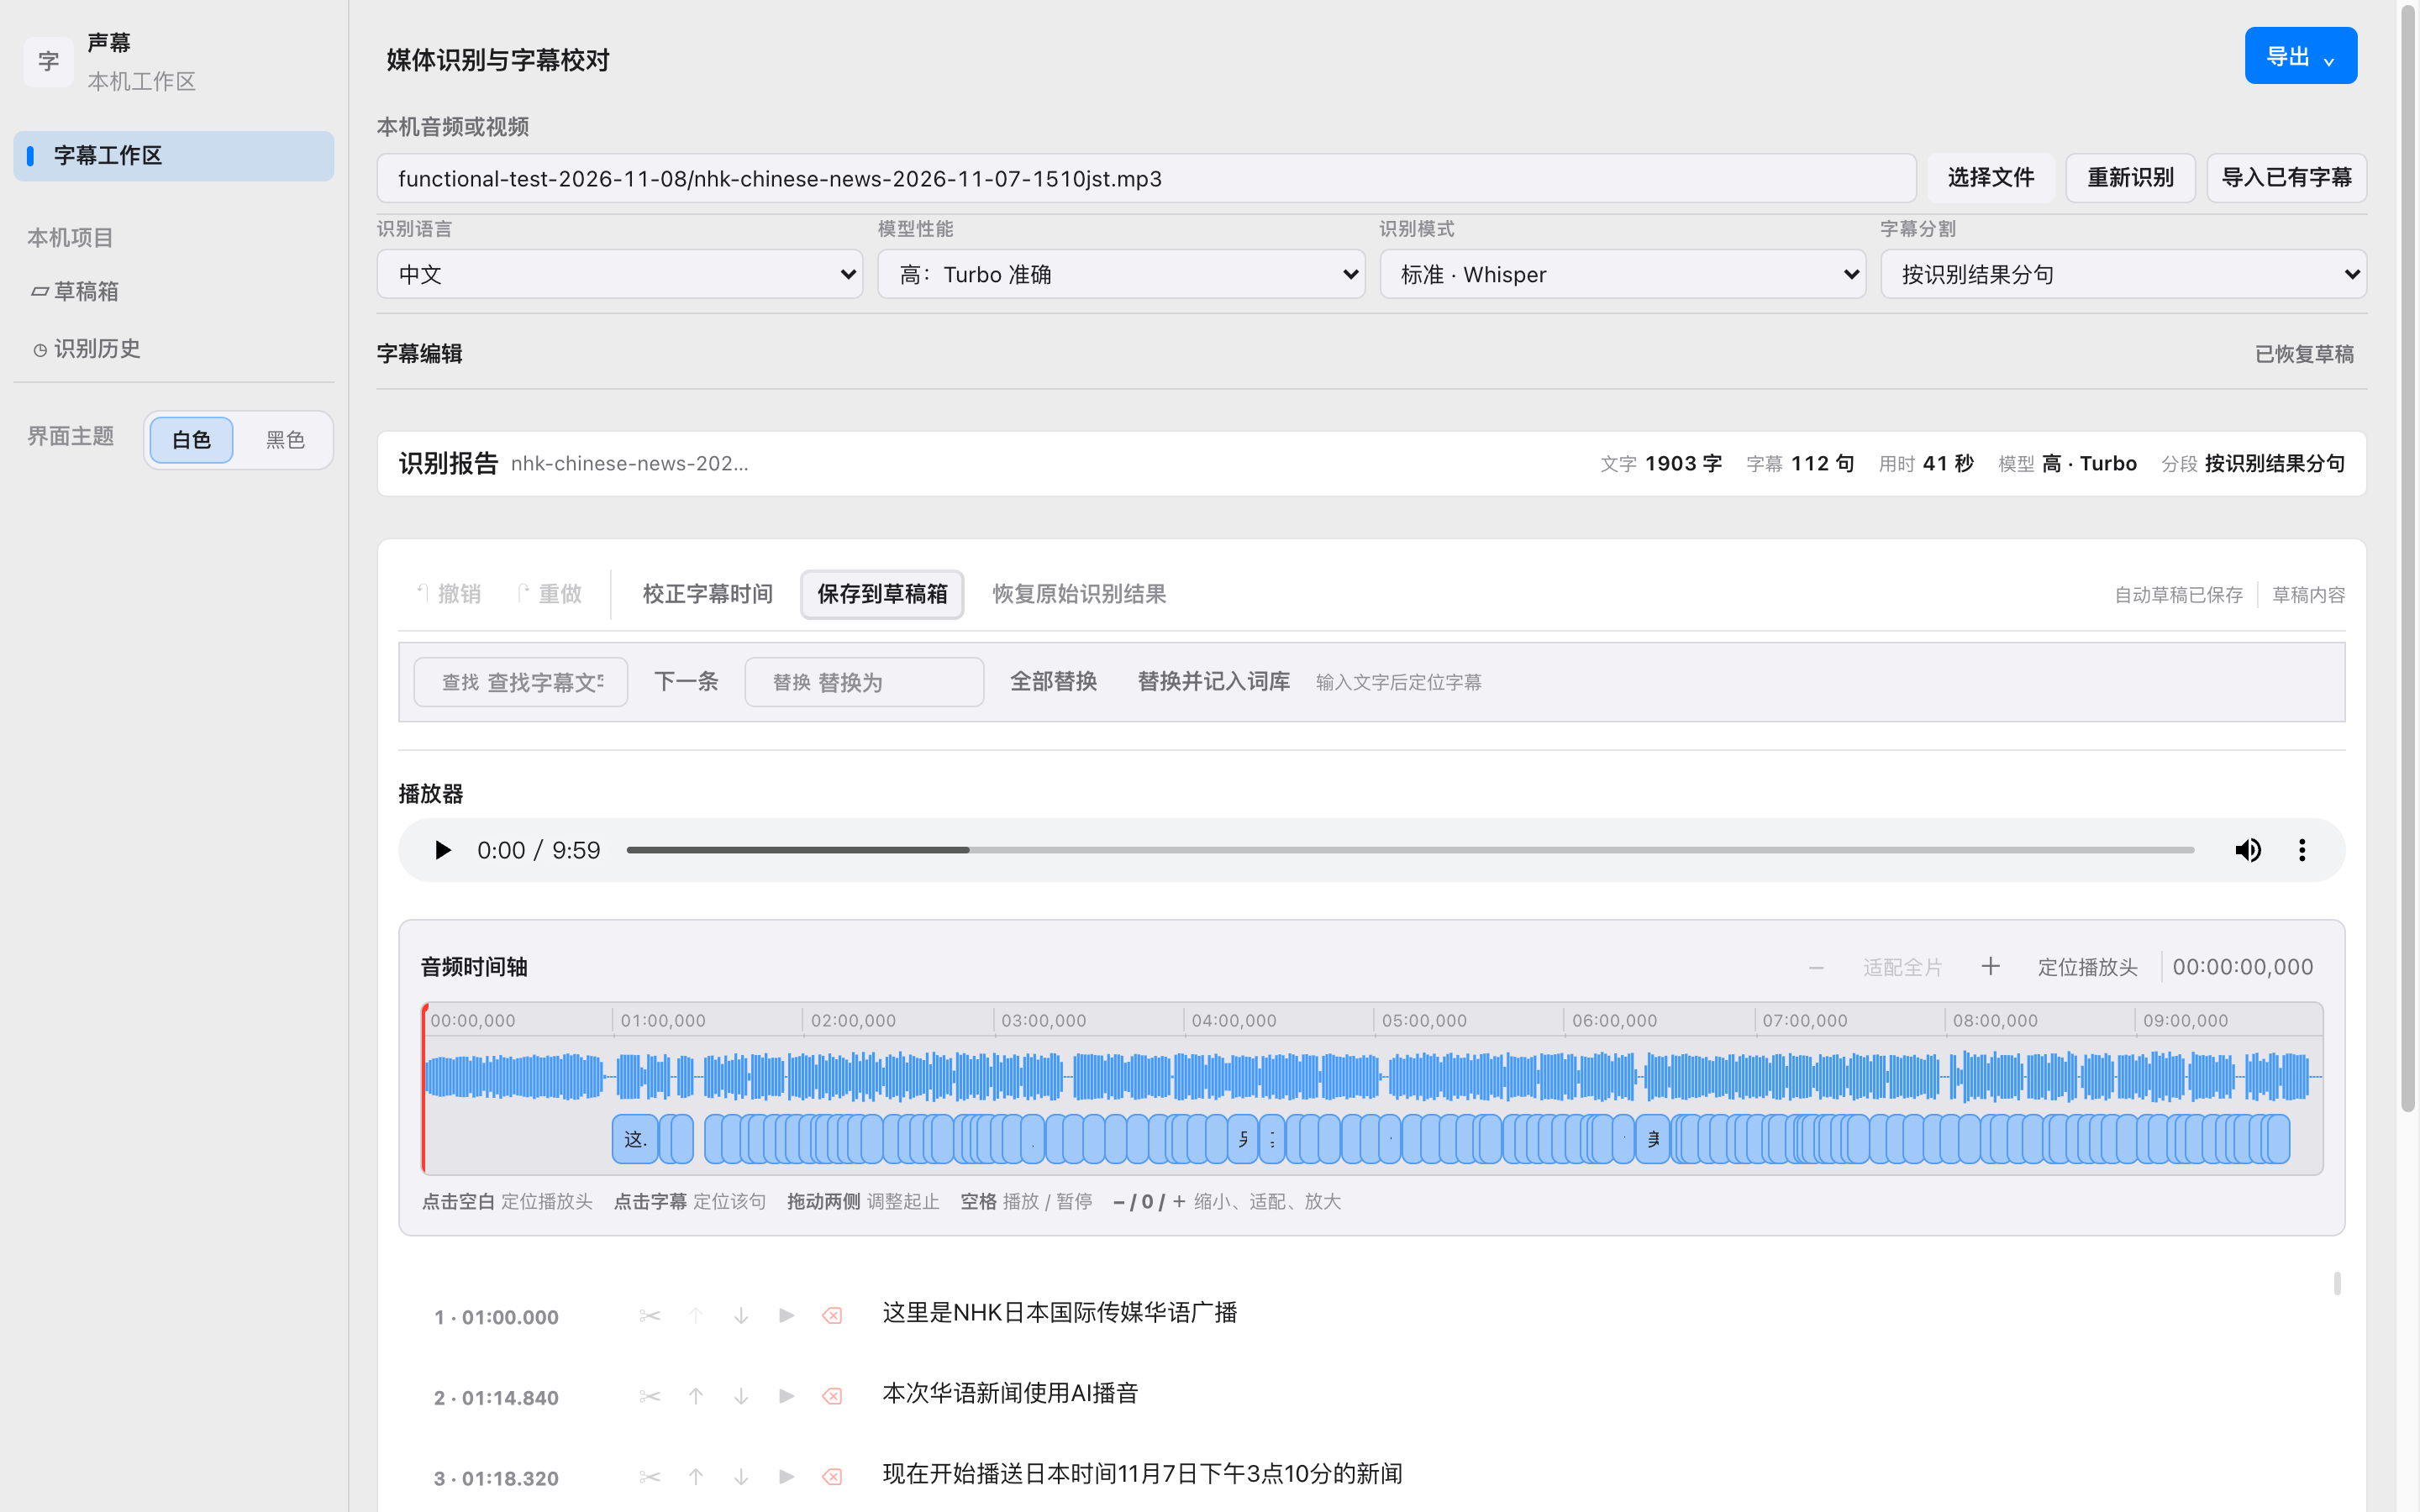
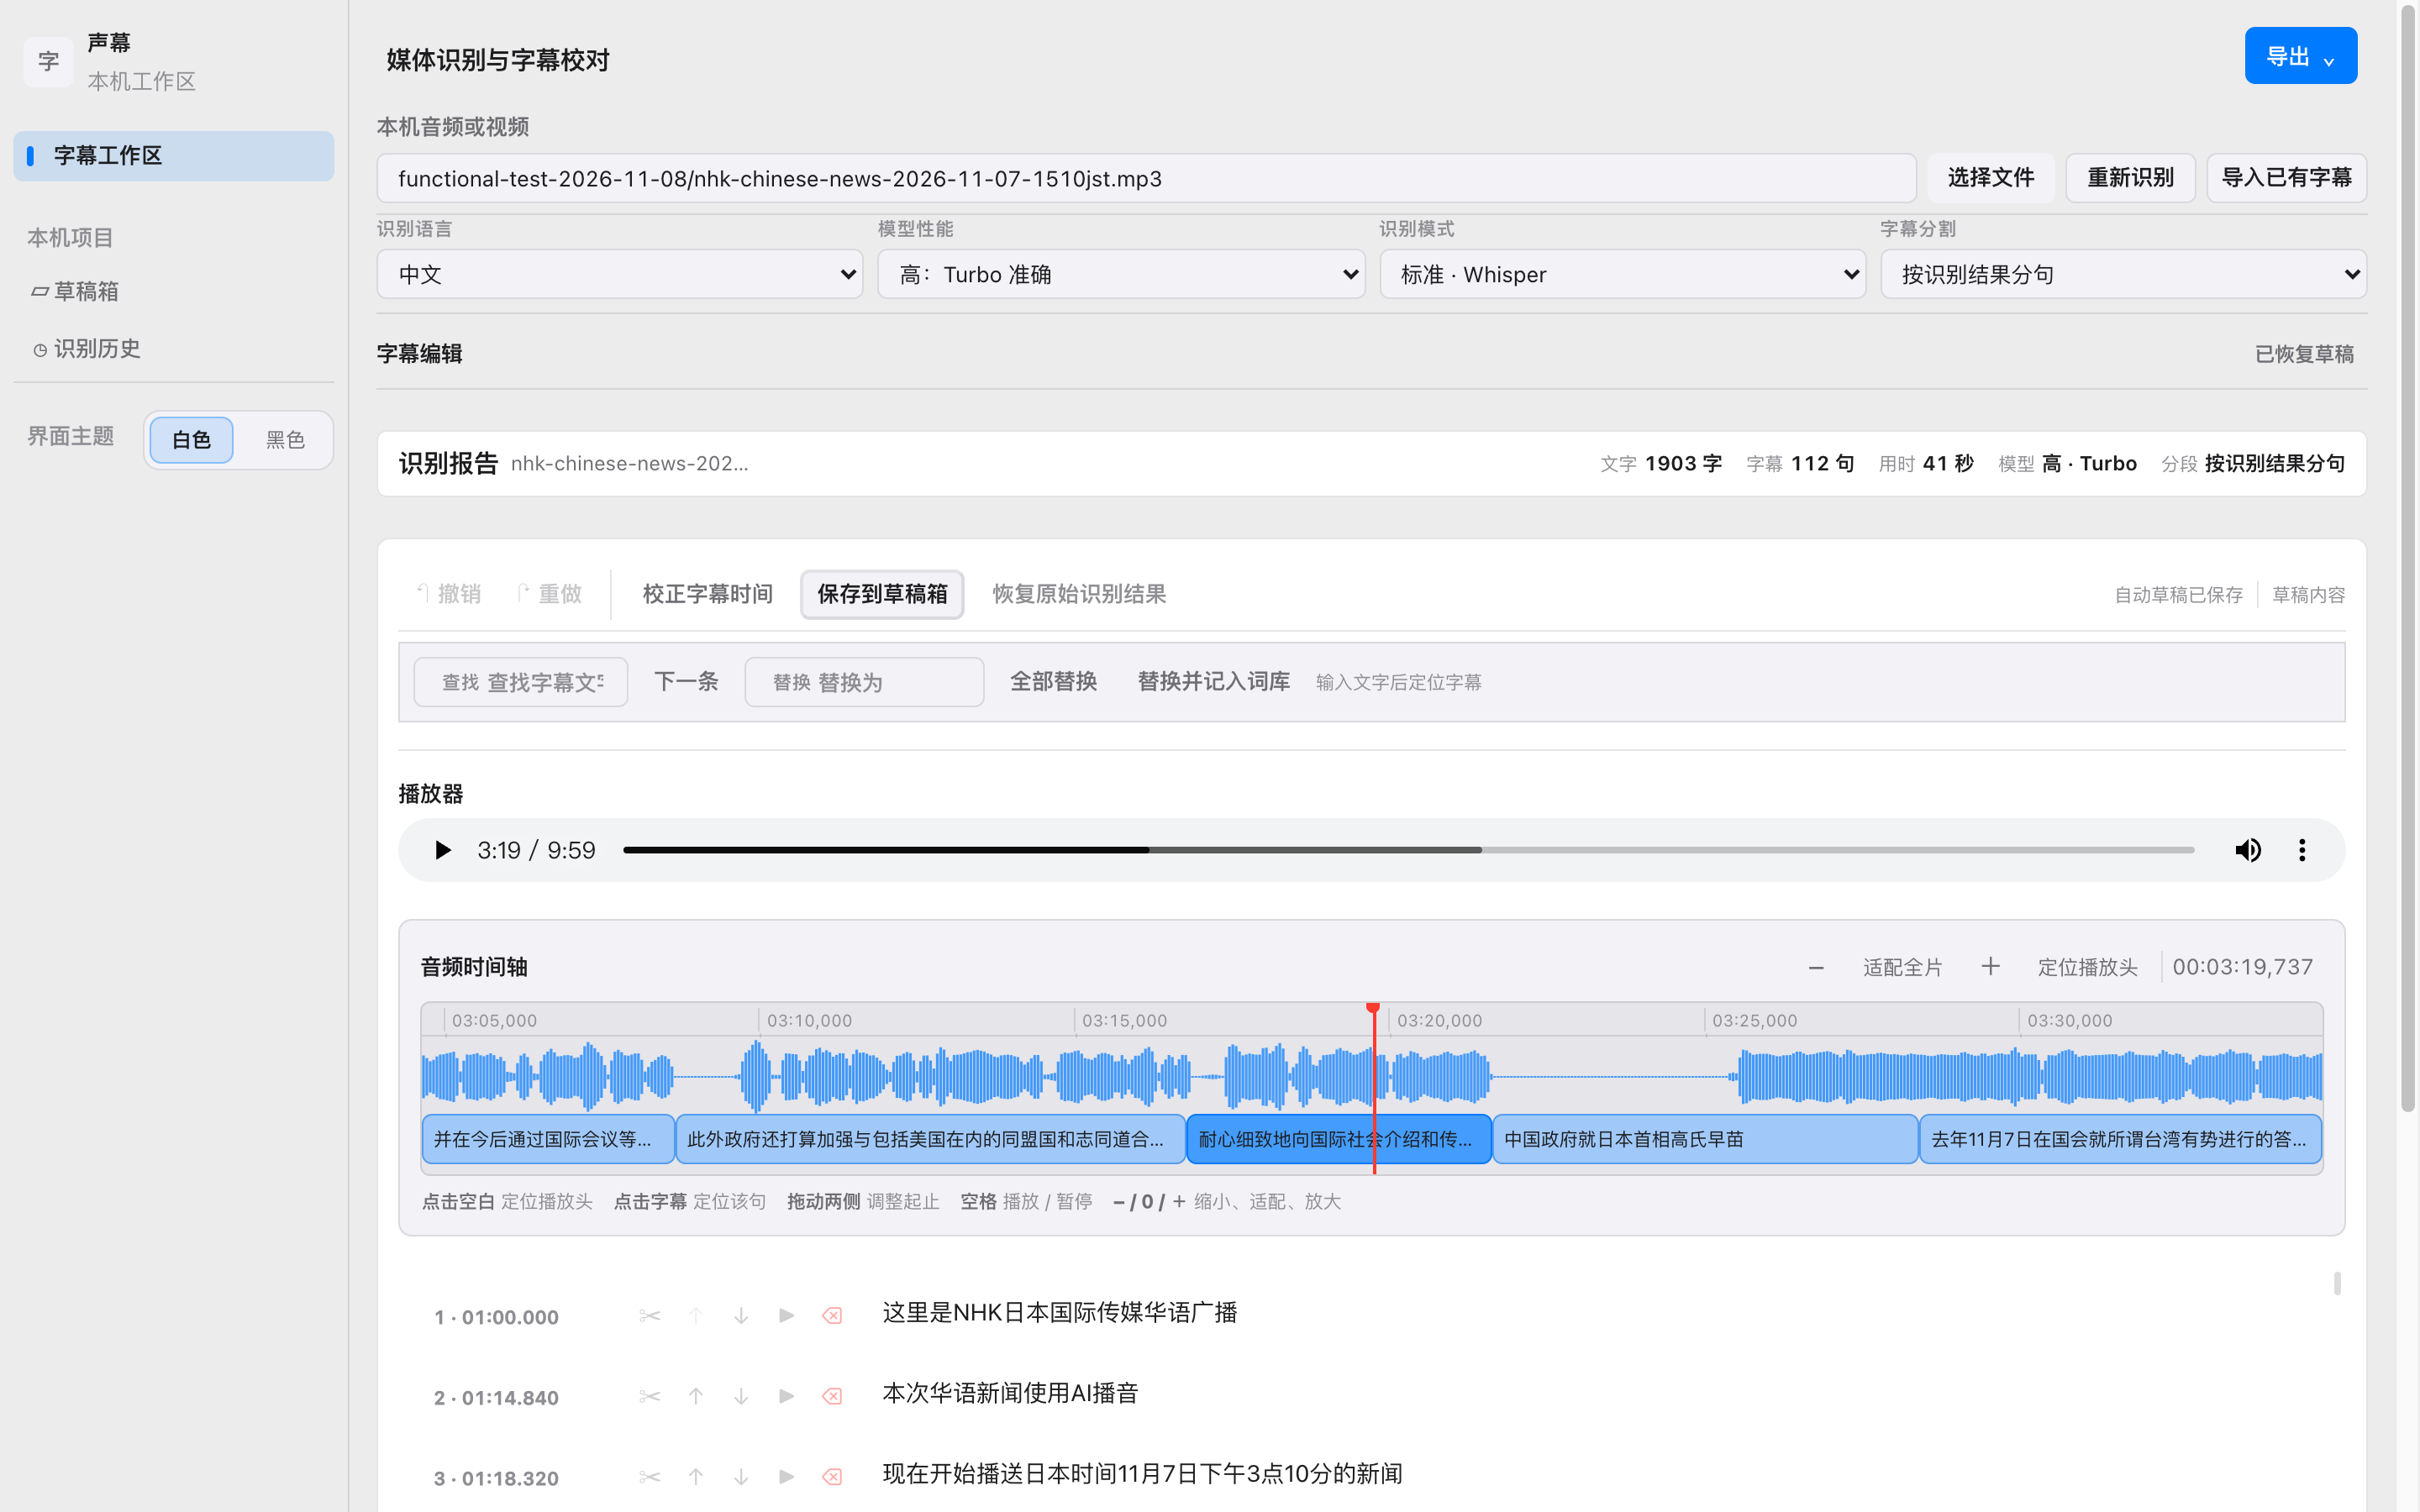
识别、校对、导入和导出,都在这台电脑上完成。
选择音频或视频,用本机 Whisper 得到字幕。高分辨率视频只取出音轨,不会把整段视频读进内存。
在时间轴上改文字、查找替换。你的词库可以在识别后纠正常见错词,时间戳不动。0.5× 到 3× 只改变试听速度,时间码不变。
可以导入已有的 SRT、WebVTT、ASS、SSA,不重新识别也能改。导出为 SRT、WebVTT、ASS 或 TXT。命名草稿保存在这台电脑上。
只做校对时不必下载识别模型。人声检测已包含在软件里(ggml-silero-v6.2.0.bin,885,098 字节)。可选的时间校正大约 1.8 GB,下载前会告诉你体积。
使用时会碰到的问题,答案直接写在下面。
不会。识别和改字幕都在你的电脑上完成,声幕没有云端识别。应用只读取你选中的文件,并在本机保存字幕、草稿和必要的临时文件。
不一定。只导入、校对和导出时,不必下载识别模型。要给新的音频或视频做识别时,再下载 Whisper,大约 78 MB、252 MB 或 834 MB,下载前能看到体积。用来区分人声和静音的文件随软件提供,是 ggml-silero-v6.2.0.bin(885,098 字节),不用另下。
这是可选步骤。Whisper 先写出字幕,千问再把时间对齐得更准,并不负责把语音转成文字。这项模型大约 1.8 GB,需要时才下载,下载前会显示体积。还没下载时,软件会提示你,不会自己交差。
这个开关现在还不能用。苹果语音识别是系统能力,不进入模型管理,也不用当作识别模型下载。设置里可能会看到它,而且可能只在 macOS 26 及以上出现,但目前只是预览,还没有接到识别流程。现在的识别仍然是本机 Whisper。
可以。导入 SRT、WebVTT、ASS 或 SSA 之后,就能在本机试听、修改和导出。
可以导出改好的 SRT、WebVTT、ASS 和 TXT。
写信到 6666699999@live.com。请不要附上密码、密钥、完整的音视频,或未打码的字幕稿。本站不提供下载或购买入口。
声幕与智剪 TalkTrim 是同一组 macOS 剪辑工具。智剪给 Final Cut Pro 的口播项目做可审核的粗剪建议,声幕负责本机识别和字幕校对。 智剪官网